谷歌 Gemini 3.8 Live 正式亮相,新增后台思考与工具调用能力


根据简鹿办公了解,谷歌刚刚正式发布了 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 两款模型,带来了近实时推理、语音与思考同步处理以及后台工具执行等重磅能力。目前,这两款模型已全面面向开发者 API 和消费者平台开放。
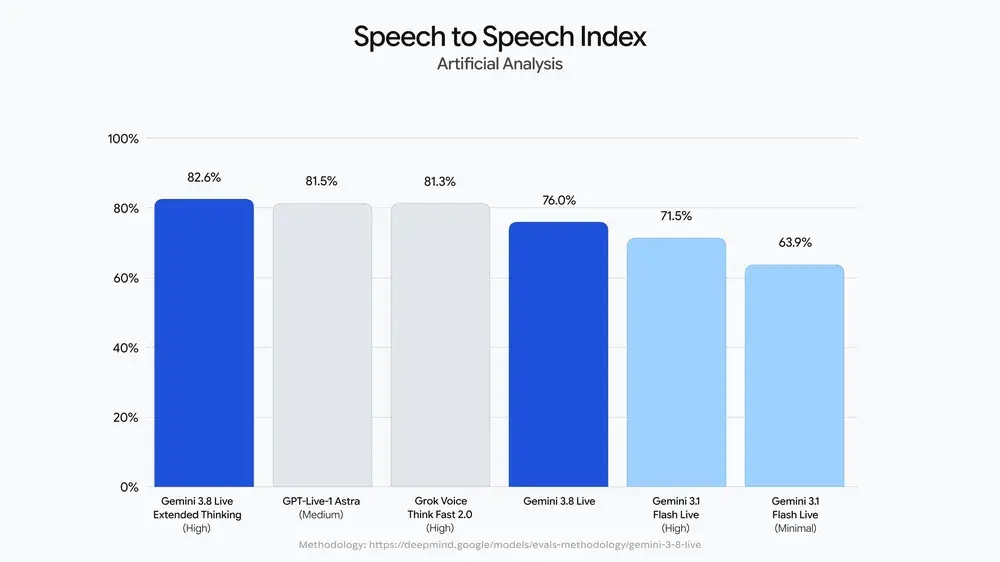
新模型的推送工作已经全面展开。其中,Gemini 3.8 Live 已即时登陆 Gemini API、Google AI Studio、Search Live,并在 Gemini Enterprise 中开启企业私密预览。而 Gemini 3.8 Live Extended Thinking 除了面向开发者和企业预览外,还向 Google Workspace(包括 Docs、Gmail、Keep)的订阅用户以及 Gemini Live 用户开放。该模型在各项基准测试中取得了顶尖成绩,包括在 Artificial Analysis 的语音对语音质量指数(Speech to Speech Quality Index)中斩获 82.6 分的高分。
在性能表现方面,Gemini 3.8 Live 在语音智能体竞技场(Speech Agent Arena)中位居第二;Gemini 3.8 Live Extended Thinking 则在 T-Voice 测试中获得 68.6% 的得分,在 Sierra 的 T-Voice-banking 基准测试中达到 35.1%,并在 Big Bench Audio 测试中取得了 97.7% 的优异成绩。
这两款模型的一大核心亮点在于,它们能够在保持对话连贯的同时,在后台静默执行工具调用和 API 请求。这意味着当 AI 外出搜索网页或处理复杂任务时,用户可以继续与它畅聊,无需忍受漫长的等待和频繁的对话中断,从而带来更加自然、流畅的通话体验。
此外,新模型还包含多项先进功能,例如支持在 97 种语言之间进行自动检测与对话中途无缝切换、具备近实时的视觉定位能力,以及在执行扩展思考任务时,会通过“让我确认一下...”等早期口头提示来自然回应用户。
开发者现在也可以通过 Agora、LiveKit、Vercel、Pipecat、Fishjam 和 Vision Agents 等合作伙伴平台集成这些新模型。谷歌还确认,所有由 AI 生成的音频均嵌入了不可见的 SynthID 数字水印,以便在虚假信息日益泛滥的当下,能够有效识别和追溯 AI 生成内容。